from pathlib import Path

DATA_DIR = Path("data/pandas")12 pandas
12.1 Namen poglavja
pandas je osrednja Pythonova knjižnica za delo s tabelaričnimi podatki. Če je NumPy naravna izbira za polja in numerične operacije, je pandas najbolj uporaben takrat, ko podatke razumemo kot tabelo z vrsticami, stolpci in oznakami.
V praksi ga uporabljamo, ko želimo:
- prebrati podatke iz
CSV,Excelali podobnih virov, - hitro pregledati strukturo tabele,
- izbrati zanimive vrstice in stolpce,
- filtrirati podatke po pogojih,
- dopolniti ali preimenovati stolpce,
- združevati več tabel,
- izračunati povzetke po skupinah,
- pripraviti atributne podatke za nadaljnjo analizo ali vizualizacijo.
V tem poglavju je glavni cilj, da pandas razumemo kot most med numeričnim delom in resno analizo podatkov. Posebej pomemben bo pozneje tudi za delo z atributnimi tabelami v GeoPandas.
12.2 Podatki v repozitoriju
Poglavje in spremljevalne vaje so zdaj povezani z dejanskimi podatki iz izvornih repozitorijev. V tej knjigi so relevantne datoteke zbrane v mapi data/pandas:
bikes.csv,weather_2012.csv,ljubljana2020.csv,covid19_si.csv.
Za preglednejšo uporabo je praktično, da si na začetku določimo pot do te mape:
Tako bomo tudi v nadaljevanju lažje brali konkretne primere iz lokalnih datotek, ne pa le iz umetno sestavljenih učnih mini tabel.
12.3 Kaj sta Series in DataFrame
Osnovni podatkovni strukturi v pandas sta:
Series, ki predstavlja enodimenzionalno zaporedje vrednosti z oznakami,DataFrame, ki predstavlja tabelo z vrsticami in stolpci.
Series si lahko predstavljamo kot označen stolpec, DataFrame pa kot celotno tabelo, v kateri imajo lahko stolpci različne podatkovne tipe.
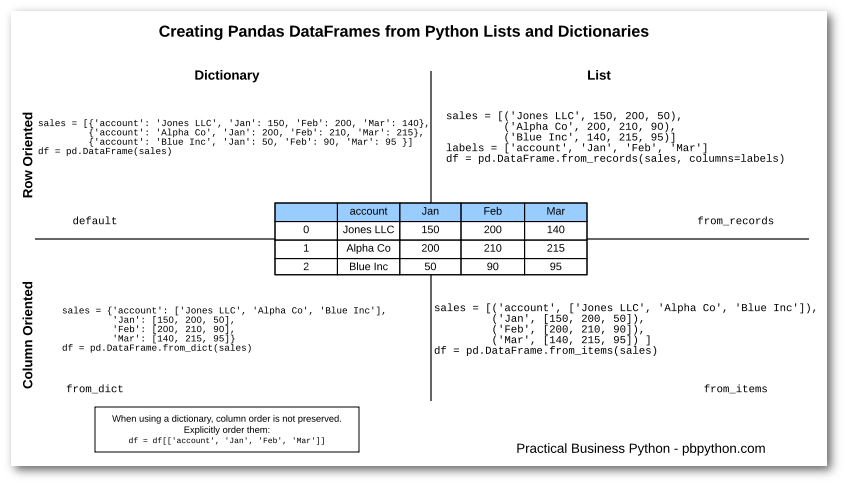
DataFrame je pregledna tabela z vrsticami, stolpci in oznakamiTo je pomembna razlika glede na NumPy:
- v
NumPyjuso podatki navadno homogeni in indeksirani predvsem po položaju, - v
pandaspa imajo vrstice in stolpci tudi pomenljive oznake.
Zato je pandas posebej primeren za meritve, sezname, evidence, časovne vrste in atributne tabele.
12.4 Uvoz knjižnice
Najpogostejši uvoz je:
import pandas as pdPo potrebi pogosto uvozimo še NumPy in matplotlib:
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("module://matplotlib_inline.backend_inline")
import matplotlib.pyplot as plt
Kratica pd je v praksi standardna in jo boste srečali skoraj povsod.
12.5 Ustvarjanje osnovnih struktur
Preprosto serijo lahko ustvarimo takole:
s = pd.Series([1, 3, 5, np.nan, 6, 8])
print(s)
0 1.0
1 3.0
2 5.0
3 NaN
4 6.0
5 8.0
dtype: float64Podatkovni okvir pa pogosto ustvarimo iz slovarja:
df = pd.DataFrame(
    {
        "mesto": ["Ljubljana", "Maribor", "Celje", "Koper"],
        "temperatura": [28, 30, 27, 29],
        "padavine": [2.1, 0.0, 5.4, 1.2],
        "regija": ["osrednja", "stajerska", "stajerska", "primorska"],
    }
)

print(df)
mesto temperatura padavine regija
0 Ljubljana 28 2.1 osrednja
1 Maribor 30 0.0 stajerska
2 Celje 27 5.4 stajerska
3 Koper 29 1.2 primorskaTo je eden najpogostejših načinov za pripravo manjših učnih primerov ali ročno sestavljenih testnih podatkov.
Podatkovni okvir lahko ustvarimo tudi iz NumPy matrike:
dates = pd.date_range("2024-01-01", periods=6)
df_num = pd.DataFrame(np.random.randn(6, 4), index=dates, columns=list("ABCD"))
print(df_num)
A B C D
2024-01-01 1.404471 0.947656 -0.711622 0.644033
2024-01-02 0.516076 -0.525638 1.116957 -1.043621
2024-01-03 -1.325041 0.309181 0.039489 -1.372366
2024-01-04 0.459444 0.486944 0.469757 -0.377955
2024-01-05 -1.355597 -0.545075 1.254037 0.175139
2024-01-06 0.869722 -1.257158 -0.903981 -0.773243Tak primer lepo pokaže, da se pandas naravno naslanja na NumPy.
12.6 Prvi pregled podatkov
Ko preberemo ali ustvarimo tabelo, nas najprej zanimajo njene osnovne značilnosti.
Najpogostejši ukazi so:
head()za prvih nekaj vrstic,tail()za zadnjih nekaj vrstic,columnsza imena stolpcev,indexza oznake vrstic,dtypesza podatkovne tipe,describe()za osnovni statistični povzetek.
print(df.head())
print(df.columns)
print(df.dtypes)
print(df.describe())
mesto temperatura padavine regija
0 Ljubljana 28 2.1 osrednja
1 Maribor 30 0.0 stajerska
2 Celje 27 5.4 stajerska
3 Koper 29 1.2 primorska
Index(['mesto', 'temperatura', 'padavine', 'regija'], dtype='str')
mesto str
temperatura int64
padavine float64
regija str
dtype: object
temperatura padavine
count 4.000000 4.000000
mean 28.500000 2.175000
std 1.290994 2.315707
min 27.000000 0.000000
25% 27.750000 0.900000
50% 28.500000 1.650000
75% 29.250000 2.925000
max 30.000000 5.400000To je prvi korak, ki ga je smiselno narediti skoraj pri vsakem novem naboru podatkov.
Če beremo podatke iz datoteke, je zelo koristno tudi:
df.info()<class 'pandas.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 4 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 mesto 4 non-null str
1 temperatura 4 non-null int64
2 padavine 4 non-null float64
3 regija 4 non-null str
dtypes: float64(1), int64(1), str(2)
memory usage: 260.0 bytesUkaz info() pokaže:
- koliko vrstic ima tabela,
- kateri stolpci obstajajo,
- koliko manjkajočih vrednosti je v posameznem stolpcu,
- katere tipe podatkov je
pandasprepoznal.
12.7 Branje podatkov iz CSV
Ena najpogostejših nalog je branje podatkov iz datoteke CSV:
from pathlib import Path

DATA_DIR = Path("data/pandas")

ljubljana_raw = pd.read_csv(DATA_DIR / "ljubljana2020.csv")
print(ljubljana_raw.head())
station id station name valid povp. dnevna T [°C] \
0 _1895 LJUBLJANA - BEŽIGRAD 2020-01-01 -0.6
1 _1895 LJUBLJANA - BEŽIGRAD 2020-01-02 -2.7
2 _1895 LJUBLJANA - BEŽIGRAD 2020-01-03 -1.0
3 _1895 LJUBLJANA - BEŽIGRAD 2020-01-04 1.6
4 _1895 LJUBLJANA - BEŽIGRAD 2020-01-05 0.6
višina snežne odeje [cm] trajanje sonca [h] oblačnost [%] grmenje
0 0 6.7 7 ne
1 0 2.3 40 ne
2 0 4.4 73 ne
3 0 2.2 80 ne
4 0 7.9 7 ne V praksi moramo pogosto dodati še nekaj nastavitev:
from pathlib import Path

DATA_DIR = Path("data/pandas")

bikes = pd.read_csv(
    DATA_DIR / "bikes.csv",
    sep=";",
    encoding="latin1",
    parse_dates=["Date"],
    dayfirst=True,
    index_col="Date",
)

print(bikes.head())
Berri 1 Brébeuf (données non disponibles) Côte-Sainte-Catherine \
Date
2012-01-01 35 NaN 0
2012-01-02 83 NaN 1
2012-01-03 135 NaN 2
2012-01-04 144 NaN 1
2012-01-05 197 NaN 2
Maisonneuve 1 Maisonneuve 2 du Parc Pierre-Dupuy Rachel1 \
Date
2012-01-01 38 51 26 10 16
2012-01-02 68 153 53 6 43
2012-01-03 104 248 89 3 58
2012-01-04 116 318 111 8 61
2012-01-05 124 330 97 13 95
St-Urbain (données non disponibles)
Date
2012-01-01 NaN
2012-01-02 NaN
2012-01-03 NaN
2012-01-04 NaN
2012-01-05 NaN Tu naredimo več pomembnih stvari:
- določimo ločilo stolpcev,
- povemo, kateri stolpec predstavlja datum,
- nastavimo evropski zapis datuma,
- iz datuma naredimo indeks.
To je posebej pomembno pri časovnih vrstah, meteoroloških podatkih in drugih zaporedjih meritev.
Na primer, za vremenske podatke iz Ljubljane lahko naredimo:
vreme = pd.read_csv(
    DATA_DIR / "ljubljana2020.csv",
    parse_dates=["valid"],
    index_col="valid",
)

vreme.columns = vreme.columns.str.strip()
vreme = vreme.rename(
    columns={
        "station name": "postaja",
        "povp. dnevna T [°C]": "temperatura",
    }
)

print(vreme[["postaja", "temperatura"]].head())
postaja temperatura
valid
2020-01-01 LJUBLJANA - BEŽIGRAD -0.6
2020-01-02 LJUBLJANA - BEŽIGRAD -2.7
2020-01-03 LJUBLJANA - BEŽIGRAD -1.0
2020-01-04 LJUBLJANA - BEŽIGRAD 1.6
2020-01-05 LJUBLJANA - BEŽIGRAD 0.612.8 Izbor stolpcev in vrstic
Ena največjih prednosti pandas je zelo izrazit način izbora podatkov.
Stolpec dobimo tako:
df["temperatura"]0 28
1 30
2 27
3 29
Name: temperatura, dtype: int64Več stolpcev hkrati:
df[["mesto", "temperatura"]]| mesto | temperatura | |
|---|---|---|
| 0 | Ljubljana | 28 |
| 1 | Maribor | 30 |
| 2 | Celje | 27 |
| 3 | Koper | 29 |
Za delo z oznakami uporabljamo loc:
df.loc[0:2, ["mesto", "temperatura"]]| mesto | temperatura | |
|---|---|---|
| 0 | Ljubljana | 28 |
| 1 | Maribor | 30 |
| 2 | Celje | 27 |
Za delo po položaju uporabljamo iloc:
df.iloc[0:3, 0:2]| mesto | temperatura | |
|---|---|---|
| 0 | Ljubljana | 28 |
| 1 | Maribor | 30 |
| 2 | Celje | 27 |
Dobro pravilo je:
locuporabljamo, ko nas zanimajo oznake,ilocuporabljamo, ko nas zanima položaj.
To postane še posebej pomembno, ko imajo vrstice časovni indeks ali drugačna poimenovanja.
12.9 Filtriranje in logični pogoji
Pri analizi nas skoraj nikoli ne zanimajo vse vrstice. Pogosto želimo izbrati samo tiste, ki izpolnjujejo nek pogoj:
toplo = df[df["temperatura"] >= 29]
print(toplo)
mesto temperatura padavine regija
1 Maribor 30 0.0 stajerska
3 Koper 29 1.2 primorskaPogoje lahko tudi kombiniramo:
izbor = df[(df["temperatura"] >= 28) & (df["padavine"] < 2)]
print(izbor)
mesto temperatura padavine regija
1 Maribor 30 0.0 stajerska
3 Koper 29 1.2 primorskaZa izbor po več možnih kategorijah je uporabna metoda isin():
print(df[df["regija"].isin(["stajerska", "primorska"])]) mesto temperatura padavine regija
1 Maribor 30 0.0 stajerska
2 Celje 27 5.4 stajerska
3 Koper 29 1.2 primorskaTak zapis je veliko preglednejši kot ročno iteriranje po vrsticah.
12.10 Urejanje in dodajanje stolpcev
Tabelo lahko uredimo po vrednosti v izbranem stolpcu:
df.sort_values(by="temperatura", ascending=False)| mesto | temperatura | padavine | regija | |
|---|---|---|---|---|
| 1 | Maribor | 30 | 0.0 | stajerska |
| 3 | Koper | 29 | 1.2 | primorska |
| 0 | Ljubljana | 28 | 2.1 | osrednja |
| 2 | Celje | 27 | 5.4 | stajerska |
Nov stolpec pogosto izračunamo neposredno iz obstoječih stolpcev:
df["temperatura_F"] = df["temperatura"] * 9 / 5 + 32To je lep primer vektorizacije v pandas. Ne pišemo zanke čez posamezne vrstice, ampak izraz uporabimo nad celotnim stolpcem hkrati.
Po potrebi lahko uporabimo tudi np.where():
df["oznaka"] = np.where(df["padavine"] > 1, "mokro", "suho")Ta pristop se neposredno navezuje na prejšnje poglavje o vektorizaciji:
- izraz zapišemo enkrat,
pandasga izvede nad celotnim stolpcem,- koda ostane krajša in navadno tudi hitrejša kot ročna zanka.
12.11 Manjkajoči podatki
pandas manjkajoče vrednosti navadno predstavi kot NaN. Te so pri analizi zelo pogoste:
- pri neizmerjenih vrednostih,
- pri nepopolnih uvozih,
- pri združevanju tabel,
- pri napakah v virih podatkov.
Preprost primer:
df_missing = pd.DataFrame(
    {
        "A": [1, 2, np.nan],
        "B": [4, np.nan, 6],
    }
)
Uporabni postopki so:
dropna()za odstranjevanje manjkajočih vrstic,fillna()za nadomestitev manjkajočih vrednosti,isnull()oziromaisna()za preverjanje, kje manjkajoče vrednosti sploh so.
print(df_missing.dropna())
print(df_missing.fillna(0))
print(df_missing.isna())
A B
0 1.0 4.0
A B
0 1.0 4.0
1 2.0 0.0
2 0.0 6.0
A B
0 False False
1 False True
2 True FalsePri resničnih podatkih je zelo pomembno, da manjkajočih vrednosti ne prezremo, ampak jih obravnavamo zavestno.
12.12 Grupiranje in agregacije
Ena najmočnejših zmožnosti pandas je grupiranje:
povzetek = df.groupby("regija")[["temperatura", "padavine"]].mean()
print(povzetek)
temperatura padavine
regija
osrednja 28.0 2.1
primorska 29.0 1.2
stajerska 28.5 2.7To pomeni:
- vrstice razdelimo v skupine po stolpcu
regija, - za vsako skupino izračunamo povprečje.
Pogoste agregacije so:
sum(),mean(),min(),max(),count().
Grupiranje je naraven način za vprašanja, kot so:
- kolikšna je povprečna vrednost po regijah,
- koliko zapisov pripada posamezni kategoriji,
- kakšna je skupna količina po mesecih ali tednih.
12.13 Združevanje tabel
Pri resnejšem delu pogosto nimamo vseh podatkov v eni sami tabeli. Takrat moramo tabele združiti.
Najpogostejši pristop je merge():
temperatura = pd.DataFrame(
    {"postaja": ["A", "B", "C"], "temp": [12.4, 10.8, 8.9]}
)
regije = pd.DataFrame(
    {"postaja": ["A", "B", "C"], "regija": ["zahod", "center", "vzhod"]}
)

rezultat = pd.merge(temperatura, regije, on="postaja")
print(rezultat)
postaja temp regija
0 A 12.4 zahod
1 B 10.8 center
2 C 8.9 vzhodZa sestavljanje tabel eno pod drugo ali eno ob drugi pa uporabimo concat():
df1 = pd.DataFrame({"A": [1, 2], "B": [3, 4]})
df2 = pd.DataFrame({"A": [5, 6], "B": [7, 8]})

pd.concat([df1, df2], axis=0)
pd.concat([df1, df2], axis=1)| A | B | A | B | |
|---|---|---|---|---|
| 0 | 1 | 3 | 5 | 7 |
| 1 | 2 | 4 | 6 | 8 |
To je pomembno tudi zato, ker bomo pozneje v GeoPandas pogosto združevali geometrije z atributnimi tabelami.
12.14 Datumi, časovne vrste in ponovno vzorčenje
pandas je zelo močan tudi pri časovnih vrstah. Če je indeks časoven, lahko podatke zelo naravno režemo po datumih:
covid = pd.read_csv(
    DATA_DIR / "covid19_si.csv",
    parse_dates=["date"],
    index_col="date",
)

covid.loc["2020-03"]
covid.loc["2020-03-15":"2020-03-20", ["cases.confirmed"]]| cases.confirmed | |
|---|---|
| date | |
| 2020-03-15 | 35.0 |
| 2020-03-16 | 26.0 |
| 2020-03-17 | 10.0 |
| 2020-03-18 | 32.0 |
| 2020-03-19 | 23.0 |
| 2020-03-20 | 28.0 |
Iz časovnega indeksa lahko dobimo tudi nove informacije:
covid["mesec"] = covid.index.month
covid["dan_v_tednu"] = covid.index.dayofweek
print(covid[["mesec", "dan_v_tednu"]].head())
mesec dan_v_tednu
date
2020-02-24 2 0
2020-02-25 2 1
2020-02-26 2 2
2020-02-27 2 3
2020-02-28 2 4Zelo uporabno je tudi ponovno vzorčenje (resample):
covid_tedensko = covid[["cases.confirmed"]].resample("W").sum()
print(covid_tedensko.head())
cases.confirmed
date
2020-03-01 0.0
2020-03-08 20.0
2020-03-15 230.0
2020-03-22 192.0
2020-03-29 315.0Tako lahko dnevne podatke pretvorimo v tedenske ali mesečne povzetke. Ta logika je posebej pomembna pri vremenskih meritvah, epidemioloških podatkih in drugih časovno urejenih zapisih.
Če želimo to narediti na dejanskih podatkih iz vaj, lahko na primer tedensko seštejemo potrjene primere:
print(covid_tedensko.head()) cases.confirmed
date
2020-03-01 0.0
2020-03-08 20.0
2020-03-15 230.0
2020-03-22 192.0
2020-03-29 315.012.15 Risanje s pandas
pandas zna podatke tudi neposredno izrisati, saj za to uporablja matplotlib:
df["temperatura"].plot()
plt.show()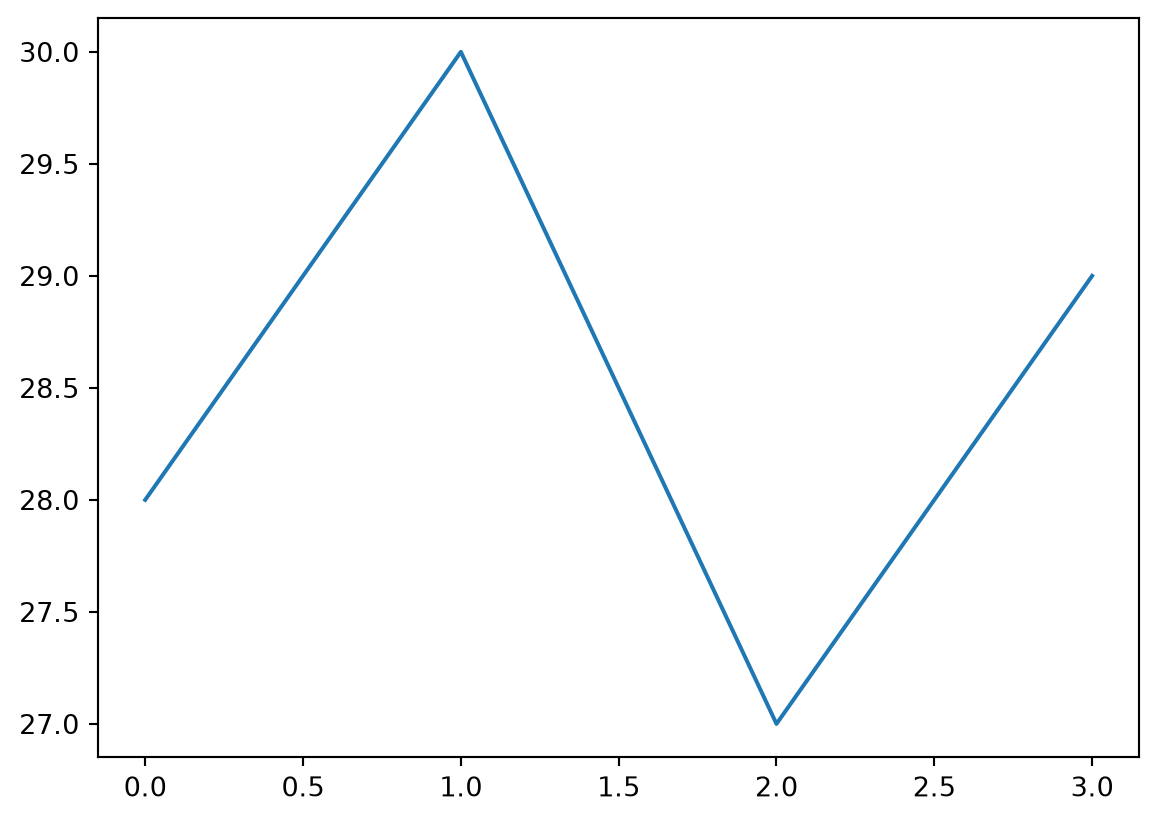
Če izrišemo več stolpcev, bo pandas poskusil prikazati vse:
df[["temperatura", "padavine"]].plot()
plt.show()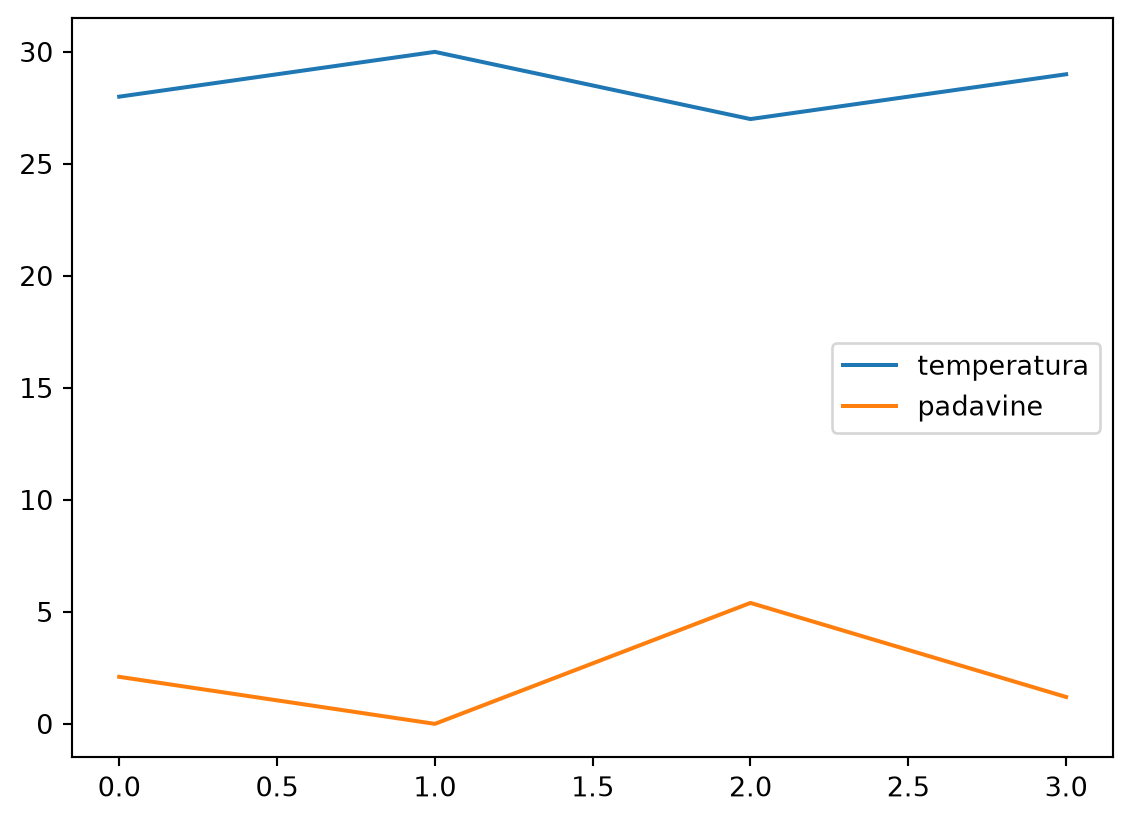
To je zelo priročno za hiter raziskovalni pogled, čeprav za bolj dodelane grafe še vedno posežemo neposredno po matplotlib.
12.16 Povezava z GeoPandas
Za geoinformatiko je pandas posebej pomemben zato, ker so atributne tabele v GeoPandas zgrajene prav na logiki DataFrame.
To pomeni, da se skoraj vse, kar smo spoznali tukaj, prenese tudi naprej:
- izbor stolpcev,
- filtriranje vrstic,
- grupiranje,
- združevanje tabel,
- delo z manjkajočimi podatki.
Ko bomo pozneje delali z vektorskimi podatki, bo razlika predvsem v tem, da bo ena od kolon geometrija, ostala logika tabel pa bo ostala zelo podobna.
12.17 Povezava s prejšnjimi poglavji
Poglavje o pandas lepo nadaljuje dosedanji tok:
NumPyuvede polja in vektorizirane izraze,SciPydoda zahtevnejše numerične metode,matplotlibrezultate prikaže,pandaspa te ideje prenese na označene tabele in realnejše podatke.
Zato je pandas eden ključnih prehodov od učnih primerov k resnični analizi podatkov.
Hkrati je to tudi zadnji splošni analitični korak pred prostorskim delom knjige: ko razumemo pandas, je prehod na atributne tabele in filtriranje v GeoPandas precej bolj naraven.
12.18 Uradna dokumentacija
Za nadaljnje branje: