import numpy as np6 NumPy
6.1 Namen poglavja
NumPy je temeljna knjižnica za numerično računanje v Pythonu. Uporablja se za delo z eno- in večdimenzionalnimi polji, hitro izvajanje računskih operacij nad večjimi količinami podatkov ter za postopke, ki jih kasneje uporabljajo tudi SciPy, pandas, matplotlib, rasterio in druge knjižnice.
Po uradni dokumentaciji je osrednja podatkovna struktura NumPyja homogeno N-dimenzionalno polje ndarray, nad katerim lahko funkcije delujejo učinkovito in pregledno. To je glavni razlog, da NumPy nastopa kot osnovni gradnik znanstvenega ekosistema v Pythonu.
V tem poglavju bomo sledili logiki začetniškega uvoda iz uradne dokumentacije NumPy: the absolute basics for beginners, vendar v bolj strnjeni, učbeniški obliki.
6.2 Zakaj uporabiti NumPy
Navadni Pythonovi seznami so zelo uporabni, vendar so splošni in prilagodljivi. NumPy pa postane posebej močan takrat, ko delamo z večjimi količinami numeričnih podatkov enakega tipa.
Njegove glavne prednosti so:
- hitrejše računanje nad homogenimi podatki,
- manjša poraba pomnilnika kot pri splošnih strukturah,
- pregleden zapis operacij nad celotnimi polji,
- enostavna razširitev od vektorjev k matrikam in višjim dimenzijam,
- dobra podlaga za linearno algebro, statistiko in obdelavo rasterjev.
Pomembna razlika v razmišljanju je, da pri NumPyju pogosto ne zapisujemo več zanke za vsak element posebej, ampak izrazimo operacijo nad celotnim poljem hkrati.
6.3 Kaj je polje ndarray
NumPy uporablja tip ndarray, kar pomeni N-dimensional array. To je lahko:
- enodimenzionalno polje, podobno vektorju,
- dvodimenzionalno polje, podobno tabeli ali matriki,
- večdimenzionalno polje, ki ga lahko razumemo kot skladovnico tabel ali mrežo podatkov.
Najpomembnejše lastnosti takega polja so:
- vsi elementi imajo isti podatkovni tip,
- skupno število elementov se po ustvarjanju ne spreminja samodejno,
- struktura mora biti pravilna oziroma “pravokotna”.
To omogoča hitrejše in bolj predvidljivo računanje.
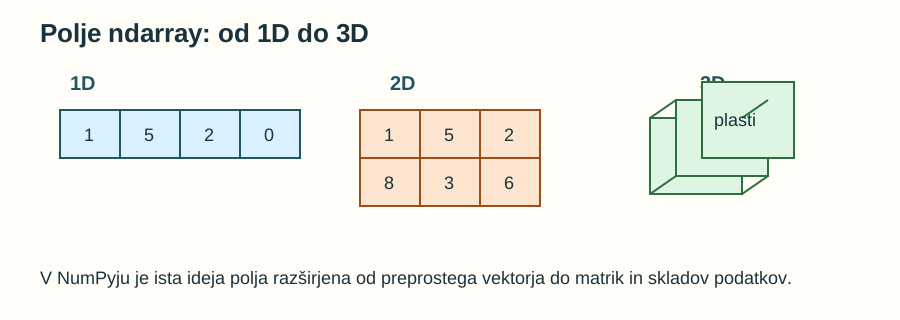
Tipične oblike polja si lahko predstavljamo takole:
| Tip | Primer oblike | Intuicija |
|---|---|---|
| 1D | (4,) |
vektor oziroma zaporedje vrednosti |
| 2D | (3, 2) |
tabela ali matrika |
| 3D | (4, 100, 100) |
skladovnica matrik, na primer več slojev podatkov |
6.4 Uvoz knjižnice
Po ustaljeni praksi NumPy uvozimo tako:
Krajšava np je standardna in jo boste videli skoraj povsod v dokumentaciji, vajah in znanstvenih zvezkih.
6.5 Ustvarjanje osnovnih polj
Najosnovnejši način je ustvarjanje iz Pythonovega seznama:
import numpy as np

a = np.array([1, 2, 3, 4, 5, 6])
print(a)
[1 2 3 4 5 6]Zelo pogosto uporabljamo tudi funkcije za pripravo osnovnih numeričnih struktur:
np.zeros(3)
np.ones(3)
np.arange(0, 10, 2)
np.linspace(0, 10, num=5)
array([ 0. , 2.5, 5. , 7.5, 10. ])Smisel posameznih funkcij:
np.zeros()pripravi polje samih ničel,np.ones()pripravi polje samih enic,np.arange()ustvari enakomerno zaporedje s podanim korakom,np.linspace()pa pripravi izbrano število enakomerno razporejenih vrednosti med dvema mejama.
Podatkovni tip lahko določimo tudi eksplicitno:
x = np.ones(4, dtype=np.int64)
print(x.dtype)int646.6 Atributi polja
Ko ustvarimo polje, nas najpogosteje zanimajo njegove osnovne značilnosti:
ndimpove število dimenzij,shapepove obliko polja,sizepove skupno število elementov,dtypepove podatkovni tip elementov.
a = np.array([[1, 2, 3], [4, 5, 6]])

print(a.ndim)
print(a.shape)
print(a.size)
print(a.dtype)
2
(2, 3)
6
int64Za razumevanje rastrskih in tabelaričnih podatkov sta predvsem shape in dtype zelo pomembna.
6.7 Indeksiranje in rezine
Posamezne elemente beremo podobno kot pri seznamih, vendar lahko pri več dimenzijah indeks podamo za vsako os posebej:
a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])

print(a[0, 0])
print(a[1, 3])
print(a[:, 1])
print(a[0:2, 0:2])
1
8
[ 2 6 10]
[[1 2]
[5 6]]Tu je dobro opozorilo iz uradne dokumentacije: NumPy je tako kot Python ničelno indeksiran, torej prvi element beremo z indeksom 0.
Pri rezinah je pomembna razlika med seznami in polji. Rezina polja pogosto vrne pogled (view) na iste podatke, ne pa popolnoma neodvisne kopije. To pomeni, da lahko sprememba rezine spremeni tudi izvorno polje.
a = np.array([10, 2, 3, 4, 5, 6])
b = a[3:]
b[0] = 40

print(a)
print(b)
[10 2 3 40 5 6]
[40 5 6]To je zelo uporabno, vendar zahteva nekaj previdnosti.
6.8 Logične maske in filtriranje
Pri analizi podatkov je zelo pogosto, da nas ne zanimajo vsi elementi, ampak samo tisti, ki izpolnjujejo nek pogoj. NumPy to omogoča z logičnimi maskami.
temperatura = np.array([12, 18, 21, 7, 25, 15])
topli_dnevi = temperatura > 18

print(topli_dnevi)
print(temperatura[topli_dnevi])
[False False True False True False]
[21 25]Tak pristop je zelo uporaben tudi pri geoprostorskih podatkih, na primer:
- kadar želimo izbrati vse celice z vrednostjo nad pragom,
- kadar želimo odstraniti neveljavne meritve,
- kadar pripravljamo masko za nadaljnje računanje.
Ker je maska sama prav tako ndarray, jo lahko kombiniramo tudi z operatorji &, | in ~.
6.9 Oblika in preoblikovanje
Ena najpomembnejših prednosti NumPyja je, da lahko iste podatke pogledamo v drugi obliki, če se skupno število elementov ne spremeni.
a = np.arange(6)
b = a.reshape(3, 2)

print(a)
print(b)
[0 1 2 3 4 5]
[[0 1]
[2 3]
[4 5]]Pravilo je preprosto: reshape() ne sme spremeniti skupnega števila elementov.
Pogosto želimo tudi iz enodimenzionalnega polja narediti stolpec ali vrstico:
a = np.array([1, 2, 3, 4])

vrstica = a[np.newaxis, :]
stolpec = a[:, np.newaxis]

print(vrstica.shape)
print(stolpec.shape)
(1, 4)
(4, 1)Tak korak je posebej koristen pri poznejši uporabi broadcasting pravil.
6.10 Osnovne operacije nad celotnim poljem
Po zgledu uradne začetniške dokumentacije je ključna ideja NumPyja, da lahko nad celotnimi polji izvajamo aritmetične operacije neposredno:
data = np.array([1, 2])
ones = np.ones(2, dtype=np.int_)

print(data + ones)
print(data - ones)
print(data * data)
print(data / data)
[2 3]
[0 1]
[1 4]
[1. 1.]Tak zapis je veliko krajši kot zapis z eksplicitnimi zankami in navadno tudi hitrejši.
6.11 Broadcasting
Broadcasting je mehanizem, s katerim NumPy razširi manjše polje ali skalar tako, da lahko izvedemo operacijo nad združljivima oblikama.
razdalje_mi = np.array([1.0, 2.0, 5.0])
razdalje_km = razdalje_mi * 1.6
print(razdalje_km)
[1.6 3.2 8. ]NumPy razume, da moramo število 1.6 uporabiti pri vsakem elementu polja. Podobna pravila veljajo tudi med polji različnih, a združljivih oblik.
To je eden od najpomembnejših konceptov v numeričnem Pythonu, ker omogoča zelo izrazit in kratek zapis izračunov.
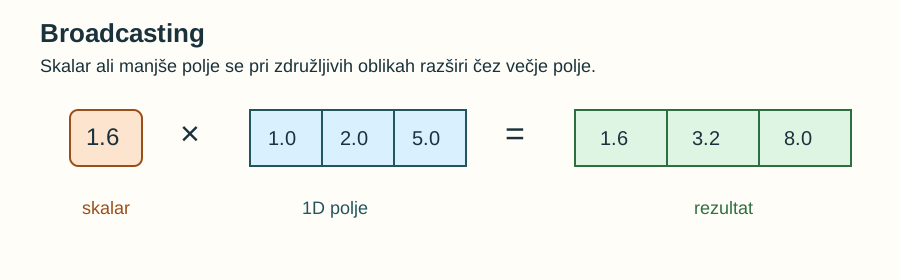
Preprost primer:
1.6 × [1.0, 2.0, 5.0] = [1.6, 3.2, 8.0]Tukaj se skalar 1.6 smiselno razširi čez vse elemente polja.
6.12 Agregacije
Poleg osnovnih operacij NumPy ponuja tudi agregacijske funkcije:
sum()za vsoto,min()inmax()za ekstreme,mean()za povprečje,std()za standardni odklon,prod()za produkt elementov.
data = np.array([1, 2, 3])

print(data.sum())
print(data.min())
print(data.max())
print(data.mean())
print(data.std())
6
1
3
2.0
0.816496580927726Pri dvodimenzionalnih poljih je posebej pomemben parameter axis, saj lahko računamo po vrsticah ali po stolpcih:
a = np.array([[1, 2, 3], [4, 5, 6]])

print(a.sum(axis=0))
print(a.sum(axis=1))
[5 7 9]
[ 6 15]6.13 Matrike in dvodimenzionalni podatki
Za delo z matrikami zadostuje, da dvodimenzionalno polje pripravimo iz seznama seznamov:
data = np.array([[1, 2], [3, 4], [5, 6]])
print(data)
[[1 2]
[3 4]
[5 6]]Na takem polju nato uporabljamo vse osnovne mehanizme:
- indeksiranje,
- rezine,
- agregacije,
- preoblikovanje,
- računanje po osi.
To je neposredno uporabno pri rastrskih podatkih, kjer je en raster pogosto mogoče razumeti prav kot numerično matriko.
Pri takih podatkih pogosto potrebujemo tudi osnovne linearnoalgebraične operacije. Za množenje matrike z vektorjem lahko uporabimo operator @:
A = np.array([[1, 2], [3, 4]])
v = np.array([10, 20])
print(A @ v)[ 50 110]Tak zapis je kratek, pregleden in pomemben most do zahtevnejših algoritmov, ki jih pozneje srečamo v SciPyju.
6.14 Uporabne operacije z obstoječimi podatki
Uradna dokumentacija za začetnike poudari tudi nekaj zelo uporabnih operacij nad obstoječimi polji:
np.sort()za sortiranje,np.concatenate()za spajanje,np.vstack()innp.hstack()za navpično in vodoravno sestavljanje,flatten()inravel()za pretvorbo v enodimenzionalno obliko.
a = np.array([2, 1, 5, 3, 7, 4, 6, 8])
print(np.sort(a))
x = np.array([[1, 2], [3, 4]])
y = np.array([[5, 6]])
print(np.concatenate((x, y), axis=0))[1 2 3 4 5 6 7 8]
[[1 2]
 [3 4]
[5 6]]Pri flatten() dobimo kopijo, pri ravel() pa pogosto pogled na iste podatke. Ta razlika je pomembna, ko pozneje spreminjamo vrednosti.
6.15 Naključne vrednosti in simulacije
Za numerične primere, simulacije in testne podatke je zelo uporabna tudi generacija naključnih vrednosti:
rng = np.random.default_rng()
vzorec = rng.random((3, 2))
print(vzorec)
[[0.99062762 0.85639576]
[0.10453557 0.63139983]
[0.48733826 0.52642209]]Tak pristop je posebej uporaben v statistiki, optimizaciji in strojnem učenju.
6.16 Matematične formule v NumPyju
Ena največjih prednosti NumPyja je, da lahko matematične formule zapišemo skoraj enako pregledno kot v matematičnem zapisu. To velja tako za preproste operacije kot za nekoliko bolj zapletene izraze.
Na primer, povprečno kvadratno napako lahko izrazimo neposredno nad polji:
napovedi = np.array([2.5, 0.0, 2.1])
opazovanja = np.array([3.0, -0.5, 2.0])

mse = ((napovedi - opazovanja) ** 2).mean()
print(mse)0.17To je zelo dober primer vektoriziranega razmišljanja: računamo nad celotnim naborom vrednosti, ne pa s pisanjem zanke za vsak element.
6.17 Povezava z naslednjimi poglavji
Po NumPyju imata naslednji poglavji precej bolj naravno mesto:
SciPyrazširi numerični del s pripravljenimi algoritmi za znanstveno računalništvo,matplotlibomogoči prikaz numeričnih rezultatov,pandasdoda delo s tabelami in atributnimi podatki.
NumPy je torej resno izhodišče za skoraj vse nadaljnje analitične teme v knjigi.
V naslednjem poglavju bomo to numerično osnovo razširili s pripravljenimi algoritmi knjižnice SciPy, takoj zatem pa bomo rezultate začeli tudi sistematično prikazovati z matplotlib.
6.18 Uradna dokumentacija
Za nadaljnje branje in dodatne primere: